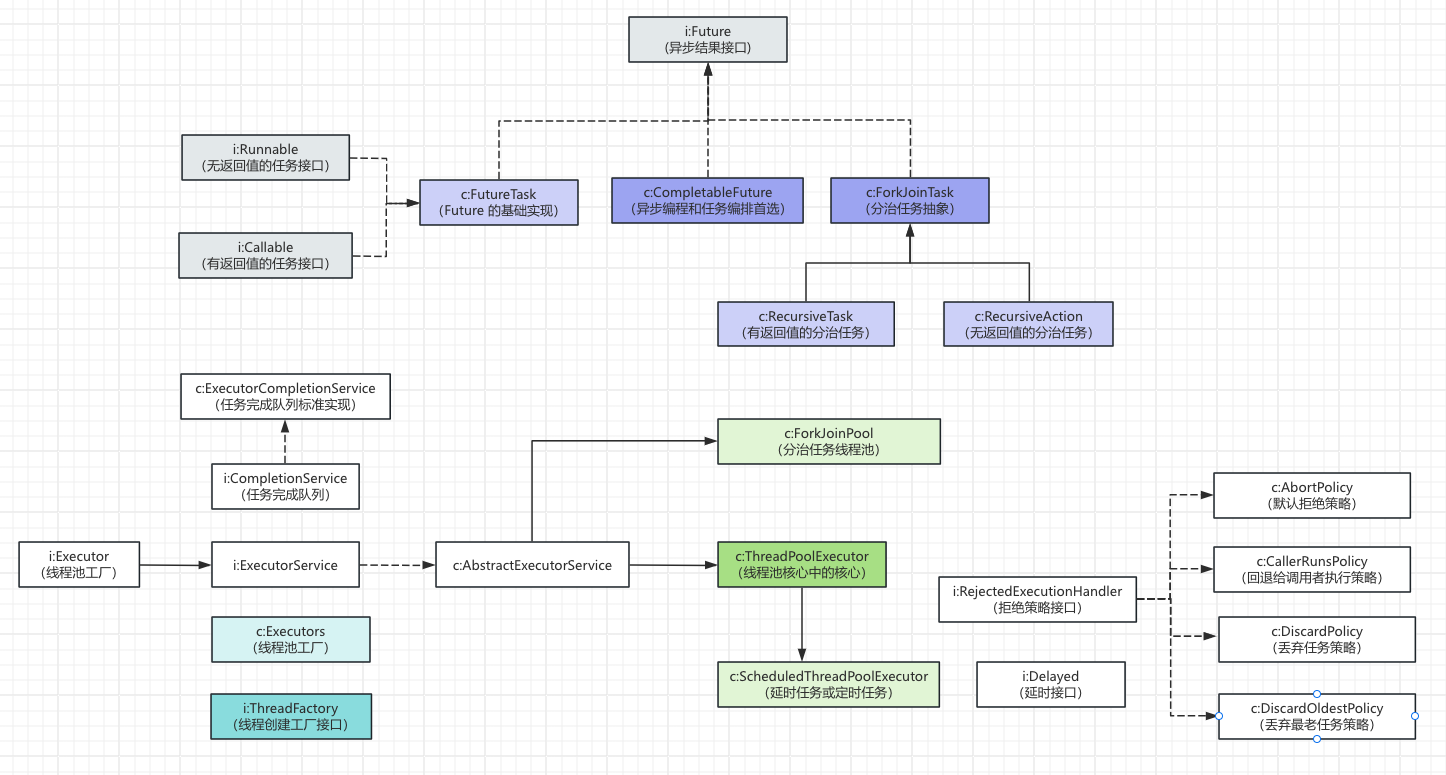
相关类的概述 在早期的 Java 并发编程中,我们习惯于直接使用 Thread 和 synchronized。但在现代高并发、高可用的互联网环境下,这种 “小作坊” 式的并发处理逻辑已无法应对。JUC 执行框架的出现,本质上是将任务的提交与执行的机制彻底解耦。
任务抽象:定义 “做什么” JUC 中的核心类(如 Runnable、Callable、FutureTask)不仅仅是简单的接口封装,它们定义了异步计算的契约:
标准任务 :通过 Callable 解决了 Runnable 无法返回结果、无法抛出异常的痛点。
Runnable:最基础任务接口,run 方法无返回值且不能抛出检查异常,属 “发后即忘”(Fire-and-forget)模式。Callable:JUC 引入的增强版,call 方法有返回值并允许抛出异常。它是获取异步计算结果的基础。
状态追踪任务 :FutureTask 和 CompletableFuture 充当了任务的 “收据”,让我们可以在未来的某个时刻,非阻塞地获取执行结果或编排后续逻辑。
FutureTask:它既实现了 Runnable 又包装了 Future,既可以包装一个 Callable 或 Runnable,交给线程执行,同时又能通过自身获取执行结果。它是线程池异步执行任务的标准容器。CompletableFuture:Java 8 引入的一个强大的异步编程工具类,它实现了 Future 和 CompletionStage接口,核心解决了传统Future无法异步回调、不支持任务组合编排等痛点,提供了链式调用、异步回调、任务编排等能力,是Java中处理异步任务和并行计算的核心工具。
分治任务 :ForkJoinTask 极限压榨多核 CPU 的每一份性能,专门用于 ForkJoinPool 的任务抽象,支持 fork(拆分子任务)和 join(合并子任务)。它的底层采用 “工作窃取” 和 “双端队列” 的方式,空闲线程从其他线程的任务队列尾部“窃取”任务执行,每个工作线程维护一个双端队列,正常任务从尾部入队/出队,窃取任务从头部获取,减少竞争。
RecursiveTask:定义有返回值的递归任务。适用于需要合并子任务结果的场景(如求和、查找最大值等)。
RecursiveAction:定义无返回值递归任务。适用于修改共享数据或执行副作用操作(如打印、数组修改等)。
执行引擎:定义 “怎么做” 在实际开发中,线程池(ThreadPoolExecutor 系列)扮演着资源守护者的角色:
降低开销 :通过池化技术重复利用已创建的线程,规避了频繁创建、销毁线程带来的数毫秒级延迟(这在每秒万级并发的系统中是致命的)。控制并发上限 :作为系统的 “护城河”,它能防止瞬时高流量冲垮后端资源。通过合理的队列(BlockingQueue)和拒绝策略,确保系统在超负荷时能 “优雅降级” 而非崩溃。提升响应速度 :配合 ExecutorCompletionService 或 CompletableFuture,可以将串行的业务逻辑并行化。
在设计这套体系时,Java 大师 Doug Lea 遵循了 “接口定义行为、抽象类提取共性、实现类追求性能
Executor:顶层接口,只负责 “运行” 。只有一个方法 execute(Runnable)。我认为这个接口的设计初衷就是为了彻底解耦。提交者只需知道这个任务会被执行,而不需要关心它是被谁具体怎么执行。ExecutorService:功能扩展接口,只负责 “管理” 。增加了管控生命周期相关方法。大概是 Executor 太简单了,没法关闭,没法查看任务执行结果。所以这一层增加了 shutdown()、submit()(返回 Future)等管理方法。AbstractExecutorService:模板抽象类,减少重复代码,它只关心 “如何跑出结果” 。它实现了 submit 等方法,将任务包装成 FutureTask,然后调用底层的 execute。ThreadPoolExecutor:最核心的线程池标准实现 ,设计的初衷就是为了解决资源爆炸问题。通过 7 大参数(核心线程、最大线程、等待队列、拒绝策略等)精准控制硬件资源的利用率。ScheduledThreadPoolExecutor(定时任务线程池):继承自 ThreadPoolExecutor,专门处理延时任务或周期性任务。内部使用 DelayedWorkQueue(小顶堆结构),确保任务能按预定时间准时触发,替代了传统简陋的 Timer。ForkJoinPool(分治任务线程池):直接继承 AbstractExecutorService,因为它不需要普通线程池那种复杂的拒绝策略和标准的队列逻辑,它有自己独特的 Work-Stealing 队列算法。当某个线程空闲时,会从其他繁忙线程的任务队列末尾 “窃取” 任务执行,极大提高了多核 CPU 在处理大规模递归任务(如 Stream 并行流)时的效率。
注意到没有?ForkJoinPool 并没有继承 ThreadPoolExecutor。ThreadPoolExecutor 是所有线程共用一个阻塞队列。而 ForkJoinPool 是每个线程都有自己的双端队列。如果强行继承 ThreadPoolExecutor,会带入大量无用的加锁逻辑(因为普通池的队列需要全局锁),这会严重拖慢 ForkJoin 的窃取效率。
结果编排:定义 “完事咋办”
CompletableFuture:异步编排神器,由 Java 8 引入,它彻底改变了 Java 异步编程的体验。它支持链式调用(thenApply、thenCombine 等)、异常处理以及多个异步任务的组合(AllOf/AnyOf),是响应式编程的重要体现。ExecutorCompletionService:它是一个结果收集器,内部维护了一个阻塞队列。当提交一批任务时,它能让我们按 “谁先做完谁先出队” 的顺序来获取结果,而不需要按提交顺序死等。
辅助类:定义 “生产标准”
Executors:提供了快速创建线程池的方法(如 newFixedThreadPool)。需要注意的是 ,这个类虽然方便,但在生产环境下应该弃用 Executors 的快捷方法,因为它默认的无界队列可能会导致 OOM,还是建议手动配置 ThreadPoolExecutor 7大参数以防止 OOM。ThreadFactory:一个简单线程定制器接口,用于定义如何创建新线程。通过自定义工厂,你可以为线程池中的线程起个好听的名字、设置优先级或设为守护线程,这对于排查 jstack 日志至关重要。
在生产环境中,JUC 类的运用应遵循以下规则:
强制手动配置:弃用 Executors 的快捷方法,通过 ThreadPoolExecutor 手动指定 7 大参数以防 OOM。
命名规范:利用 ThreadFactory 为每个业务池的线程打上唯一标签,以进行异常日志追踪。
异步编排:由简单 Future 转向 CompletableFuture,利用其回调机制彻底消除 “阻塞等待结果” 的情况。
任务类相关的案例 最基础的抽象任务 Runnable:最纯粹的 “发后即忘”,异常只能在内部处理
1 2 3 4 5 6 7 8 9 10 11 12 13 Runnable logTask = () -> { System.out.println(Thread.currentThread().getName() + " 开始记录系统日志..." ); try { Thread.sleep(1000 ); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("日志记录完成。" ); }; new Thread (logTask).start();
Callable:带反馈的任务定义(配合Future们或线程池们使用),异常可向上抛出
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
Callable<Integer> calculateTask = () -> { System.out.println("正在计算复杂的数学模型..." ); Thread.sleep(2000 ); return 42 ; }; FutureTask<Integer> futureTask = new FutureTask <>(calculateTask); new Thread (futureTask).start();try { Integer result = futureTask.get(); System.out.println("结果: " + result); } catch (Exception e) { sout("捕获到异常: " + e.getMessage()); }
Future:任务执行的 “提货单”,异常可继续向上抛出
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
ExecutorService executor = Executors.newFixedThreadPool(1 );Future<Integer> future = executor.submit(calculateTask); System.out.println("主线程可以先去处理别的事情..." ); try { Integer result = future.get(); System.out.println("最终计算结果为: " + result); } catch (Exception e) { e.printStackTrace(); } finally { executor.shutdown(); }
FutureTask:全能的 “包装者”,异常可继续向上抛出
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 FutureTask<Integer> futureTask = new FutureTask <>(() -> { System.out.println("分线程正在执行耗时统计..." ); Thread.sleep(1500 ); return 100 ; }); new Thread (futureTask).start();if (!futureTask.isDone()) { System.out.println("任务还在进行中..." ); } System.out.println("收到 FutureTask 的反馈: " + futureTask.get());
CompletableFuture API 介绍 CompletableFuture 是 Java 8 引入的异步编程里程碑,彻底解决了传统 Future 必须通过 get 阻塞获取结果或不停轮询 isDone 的尴尬。它的 API 非常丰富(约有 50 多个方法),根据 “任务流转的阶段” 和 “触发机制” 可以将其划分为以下 7 大类。
手撕一个出来 第一步:最简版——能 complete + 能阻塞等。
其实这一步就是 CF 的 80% 核心:volatile result + CAS 入栈 + park/unpark 唤醒。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
import sun.misc.Unsafe;import java.lang.reflect.Field;import java.util.concurrent.atomic.AtomicReference;import java.util.concurrent.atomic.AtomicReferenceFieldUpdater;import java.util.concurrent.locks.LockSupport;public class MyCompleteFuture <T> { private volatile Object result; private static final Object NULL = new Object (); private final AtomicReference<WaitNode> waiters = new AtomicReference <>(); private static final Unsafe U; private static final long resultOffset; static { try { Field theUnsafe = Unsafe.class.getDeclaredField("theUnsafe" ); theUnsafe.setAccessible(true ); U = (Unsafe) theUnsafe.get(null ); resultOffset = U.objectFieldOffset(MyCompleteFuture.class.getDeclaredField("result" )); } catch (NoSuchFieldException | IllegalAccessException e) { throw new RuntimeException (e); } } private static class WaitNode { final Thread thread; volatile WaitNode next; WaitNode() { this .thread = Thread.currentThread(); } } public void complete (T value) { Object val = value == null ? NULL : value; if (U.compareAndSwapObject(this , resultOffset, null , val)) { for (WaitNode n = waiters.getAndSet(null ); n != null ; n = n.next) { LockSupport.unpark(n.thread); } } } public T join () { Object r; while ((r = result) == null ) { WaitNode node = new WaitNode (); WaitNode old = waiters.get(); node.next = old; if (!waiters.compareAndSet(old, node)) { continue ; } if (result != null ) { LockSupport.unpark(node.thread); break ; } LockSupport.park(this ); } return r == NULL ? null : (T) r; } public static void main (String[] args) { MyCompleteFuture<String> f = new MyCompleteFuture <>(); new Thread (() -> { try { Thread.sleep(2000 ); } catch (InterruptedException ignored) {} f.complete("hello" ); }).start(); System.out.println("等结果..." ); System.out.println(f.join()); } }
第二步:加 thenApply(同步回调)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
public <U> MyCompleteFuture<U> thenApply (Function<? super T, ? extends U> fn) { MyCompleteFuture<U> downstream = new MyCompleteFuture <>(); registerCallback(() -> { T value = this .join(); U result = fn.apply(value); downstream.complete(result); }); return downstream; } private void registerCallback (Runnable task) { CallbackNode node = new CallbackNode (task); if (result != null ) { task.run(); return ; } CallbackNode old; do { old = callbackHead.get(); node.next = old; } while (!callbackHead.compareAndSet(old, node)); } private static class CallbackNode { final Runnable task; volatile CallbackNode next; CallbackNode(Runnable task) { this .task = task; } } private volatile CallbackNode callbacks;private final AtomicReference<CallbackNode> callbackHead = new AtomicReference <>();
然后在 complete() 里,除了唤醒 waiters,还要执行 callbacks:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
private static final AtomicReferenceFieldUpdater<MyCompleteFuture, Object> RESULT_FIELD_UPDATER = AtomicReferenceFieldUpdater.newUpdater(MyCompleteFuture.class, Object.class, "result" ); public void complete (T value) { Object val = value == null ? NULL : value; if (RESULT_FIELD_UPDATER.compareAndSet(this , null , val)) { for (WaitNode n = waiters.getAndSet(null ); n != null ; n = n.next) { LockSupport.unpark(n.thread); } for (CallbackNode n = callbackHead.getAndSet(null ); n != null ; n = n.next) { n.task.run(); } } }
测试验证:
1
2
3
4
5
6
7
8
9
10
11
public static void main (String[] args) { MyCompleteFuture<Integer> f = new MyCompleteFuture <>(); MyCompleteFuture<Integer> f2 = f.thenApply(x -> x * 2 ); new Thread (() -> { try { Thread.sleep(1000 ); } catch (InterruptedException ignored) {} f.complete(10 ); }).start(); System.out.println(f2.join()); }
完成的案例代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
import sun.misc.Unsafe;import java.lang.reflect.Field;import java.util.concurrent.atomic.AtomicReference;import java.util.concurrent.locks.LockSupport;import java.util.function.Function;public class MyCompleteFuture <T> { private volatile Object result; private static final Object NULL = new Object (); private final AtomicReference<WaitNode> waitHead = new AtomicReference <>(); private final AtomicReference<CallbackNode> callbackHead = new AtomicReference <>(); private static final Unsafe U; private static final long resultOffset; static { try { Field theUnsafe = Unsafe.class.getDeclaredField("theUnsafe" ); theUnsafe.setAccessible(true ); U = (Unsafe) theUnsafe.get(null ); resultOffset = U.objectFieldOffset(MyCompleteFuture.class.getDeclaredField("result" )); } catch (Exception e) { throw new RuntimeException (e); } } private static class WaitNode { private final Thread thread; private volatile WaitNode next; public WaitNode () { this .thread = Thread.currentThread(); } } private static class CallbackNode { final Runnable task; volatile CallbackNode next; CallbackNode(Runnable task) { this .task = task; } } public void complete (T value) { Object val = value == null ? NULL : value; if (U.compareAndSwapObject(this , resultOffset, null , val)) { WaitNode n1 = waitHead.getAndSet(null ); for (; n1 != null ; n1 = n1.next) { LockSupport.unpark(n1.thread); } CallbackNode n2 = callbackHead.getAndSet(null ); for (; n2 != null ; n2 = n2.next) { n2.task.run(); } } } public T join () { Object r; while ((r = result) == null ) { WaitNode newNode = new WaitNode (); WaitNode oldNode = waitHead.get(); newNode.next = oldNode; if (!waitHead.compareAndSet(oldNode, newNode)) { continue ; } if (result != null ) { LockSupport.unpark(newNode.thread); break ; } LockSupport.park(this ); } return r == NULL ? null : (T) r; } public <U> MyCompleteFuture<U> thenApply (Function<? super T, ? extends U> fn) { MyCompleteFuture<U> downstream = new MyCompleteFuture <>(); registerCallback(() -> { T value = this .join(); U result = fn.apply(value); downstream.complete(result); }); return downstream; } private void registerCallback (Runnable task) { if (result != null ) { task.run(); return ; } CallbackNode newNode = new CallbackNode (task); CallbackNode oldNode; do { oldNode = callbackHead.get(); newNode.next = oldNode; } while (!callbackHead.compareAndSet(oldNode, newNode)); } public static void main (String[] args) { MyCompleteFuture<Integer> f1 = new MyCompleteFuture <>(); MyCompleteFuture<Integer> f2 = f1.thenApply(x -> x * x); MyCompleteFuture<String> f3 = f2.thenApply(x -> x + " hehe" ); new Thread (() -> { try { Thread.sleep(1000 ); } catch (InterruptedException ignored) {} f1.complete(10 ); }).start(); System.out.println(f3.join()); } }
一些案例 下面我们通过一些小案例,来具体看看这个类的具体用法 。
异步任务链:thenApply (流水线模式)
场景:模拟电商下单流程:1.查询价格 -> 2.计算折扣 -> 3.生成账单。每一跳都依赖前一跳的结果。
1
2
3
4
5
6
7
8
9
10
11
12
13
CompletableFuture<String> orderFuture = CompletableFuture.supplyAsync(() -> { System.out.println("Step 1: 查询商品原始价格..." ); return 1000 ; }).thenApply(price -> { System.out.println("Step 2: 应用 8 折优惠券..." ); return price * 0.8 ; }).thenApply(finalPrice -> { return "Step 3: 最终账单金额为: " + finalPrice; }); System.out.println("订单正在后台处理,主线程先去渲染 UI 了..." ); System.out.println(orderFuture.join());
异步任务的 “套娃” 摊平:thenCompose
场景:你需要先异步获取 “用户ID”,拿到 ID 后再异步获取 “该用户的订单”。
如果用 thenApply,返回值会变成 CompletableFuture<CompletableFuture<Order>> 产生嵌套,而 thenCompose 会将结果 “摊平”,返回 CompletableFuture<Order>。
1
2
3
4
5
6
7
CompletableFuture<String> userIdFuture = CompletableFuture.supplyAsync(() -> "User_123" ); CompletableFuture<String> orderFuture = userIdFuture.thenCompose(userId -> CompletableFuture.supplyAsync(() -> "Order_of_" + userId) ); System.out.println(orderFuture.join());
多任务组合:thenCombine (结果聚合模式)
场景:首页展示需要同时获取 “用户信息” 和 “广告推荐”,两者互不依赖,但最终需要合并成一个对象发给前端。
注意:如果参与合并的其中一个任务抛出异常,那么最终合并后的 Future 也会直接进入异常处理流程。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
CompletableFuture<String> userFuture = CompletableFuture.supplyAsync(() -> { return "User: ZhangSan" ; }); CompletableFuture<String> adsFuture = CompletableFuture.supplyAsync(() -> { return "Ads: Owlias Keyboards" ; }); CompletableFuture<String> pageFuture = userFuture.thenCombine(adsFuture, (user, ads) -> { return user + " | " + ads; }); System.out.println("渲染首页: " + pageFuture.join());
多任务并行:allOf (分布式查询模式)
场景:在后台需要同时扫描 10 篇文章的 SEO 状态。你希望等所有扫描都完成后,发一个 “扫描完成” 的通知。
注意:如果其中一个任务失败,allOf 返回的 Void Future 也会被标记为失败。但由于它不直接承载结果,通常需要遍历原始列表来检查具体是哪个任务出错了。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
List<CompletableFuture<String>> futures = Stream.of("Post1" , "Post2" , "Post3" ) .map(post -> CompletableFuture.supplyAsync(() -> { System.out.println("正在扫描: " + post); return post + " OK" ; })).toList(); CompletableFuture<Void> allDone = CompletableFuture.allOf(futures.toArray(new CompletableFuture [0 ])); allDone.thenRun(() -> { System.out.println("所有文章 SEO 扫描任务已完成!" ); }).join(); List<String> results = CompletableFuture.allOf(futures.toArray(new CompletableFuture [0 ])) .thenApply(v -> futures.stream() .map(CompletableFuture::join) .collect(Collectors.toList()) ).join();
容错处理:exceptionally (熔断保护模式)
场景:调用远程 API 时,如果接口超时或报错,不能让整个页面崩溃,而是给出一个默认的 “兜底值”。
1
2
3
4
5
6
7
8
9
10
11
CompletableFuture<String> safetyFuture = CompletableFuture.supplyAsync(() -> { if (Math.random() > 0.5 ) { throw new RuntimeException ("API 调用失败" ); } return "远程数据内容" ; }).exceptionally(ex -> { System.out.println("捕获到异常: " + ex.getMessage()); return "【默认兜底数据】" ; }); System.out.println("最终结果: " + safetyFuture.join());
全能的结果/异常处理器:handle
场景:无论前面的任务是成功拿到了数据,还是中途崩了(抛异常),你都想统一处理。你可以通过 handle 能同时拿到 result 和 exception 两个参数,并且可以改变返回值。
1
2
3
4
5
6
7
8
9
10
11
12
CompletableFuture<Integer> handleFuture = CompletableFuture.supplyAsync(() -> { if (true ) throw new RuntimeException ("算力不足!" ); return 100 ; }).handle((res, ex) -> { if (ex != null ) { System.out.println("捕获到异常: " + ex.getMessage()); return -1 ; } return res * 2 ; }); System.out.println("结果: " + handleFuture.join());
手动给任务画句号:complete
场景:你启动了一个异步任务,但如果超过 2 秒没回消息,你想手动设置一个默认值让流程继续走下去。
注意:complete 是 “写入” 操作,它在说 “别等了,我现在就把结果定死成这个值”。而 getNow 只是 “读取” 操作,对任务完全没有影响,它只是询问 “现在有结果了吗?没有我就拿个默认值走人”。
用法:① 如果你觉得自己有更快的路子,这任务可以提前收工,那就用 complete;② 如果你等不及了,现在就要个结果,那就用 getNow。
1
2
3
4
5
6
7
8
9
10
11
12
CompletableFuture<String> manualFuture = new CompletableFuture <>(); new Thread (() -> { try { Thread.sleep(5000 ); manualFuture.complete("后台任务太慢了" ); } catch (Exception e) { } }).start(); manualFuture.complete("主线程等不及了,手动填个值" ); System.out.println(manualFuture.join());
如果在生产环境中,你需要对一个超大的 List 进行处理,且该处理逻辑非常耗时(比如涉及远程 RPC 调用获取额外的奖金数据),我们通常会选择 CompletableFuture 进行异步编排:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 private static final ExecutorService BIZ_POOL = new ThreadPoolExecutor ( 4 , 8 , 60L , TimeUnit.SECONDS, new LinkedBlockingQueue <>(1000 ) ); public static void main (String[] args) { List<Emp> emps = ...; List<CompletableFuture<String>> futures = emps.stream() .map(emp -> CompletableFuture.supplyAsync(() -> { return fetchBonus(emp); }, BIZ_POOL)) .collect(Collectors.toList()); CompletableFuture<Void> allDone = CompletableFuture.allOf( futures.toArray(new CompletableFuture [0 ]) ); allDone.thenRun(() -> { System.out.println("所有异步任务已全部处理完毕" ); }).join(); }
页面加载需要同时调用 3 个服务:用户信息、订单历史、推荐列表。其中“推荐列表”是边缘业务,如果它超时(超过 500ms),我们不能让整个页面加载失败,而是要返回一个空列表。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
public class PageLoader { public CompletableFuture<String> getUserInfo () { return CompletableFuture.supplyAsync(() -> "User Data" ); } public CompletableFuture<String> getOrderHistory () { return CompletableFuture.supplyAsync(() -> "Order History" ); } public CompletableFuture<List<String>> getRecommendations () { return CompletableFuture.supplyAsync(() -> { try { Thread.sleep(800 ); } catch (InterruptedException e) {} return List.of("Item A" , "Item B" ); }); } public void loadPage () { CompletableFuture<String> userFuture = getUserInfo(); CompletableFuture<String> orderFuture = getOrderHistory(); CompletableFuture<List<String>> recFuture = getRecommendations() .orTimeout(500 , TimeUnit.MILLISECONDS) .exceptionally(ex -> { System.err.println("推荐列表加载失败/超时: " + ex.getMessage()); return Collections.emptyList(); }); CompletableFuture<Void> allFutures = CompletableFuture.allOf(userFuture, orderFuture, recFuture); allFutures.thenRun(() -> { String user = userFuture.join(); String order = orderFuture.join(); List<String> recs = recFuture.join(); System.out.println("页面数据加载完成:User=" + user + ", Order=" + order + ", Recs=" + recs); }).join(); } }
模拟 Gateway 网关层 JWT 双 Token 置换核心接口(模拟webflux mono 嵌套 mono 的异步编程模式):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
@Slf4j public class FutureAuthStateMachine { private static final ExecutorService nettyEventLoop = Executors.newFixedThreadPool(2 , r -> { Thread t = new Thread (r); t.setName("netty-event-loop-" + t.hashCode() % 2 ); return t; }); public static void main (String[] args) throws InterruptedException { FutureAuthStateMachine sandbox = new FutureAuthStateMachine (); log.info("【前端】发起 /auth/refresh 请求..." ); CompletableFuture<ResponseEntity> responseFuture = sandbox.refresh("valid_refresh_token_xyz" ); log.info("【网关核心主线程】已经解放!去接待别的前端请求了,不需要卡在这里等 Redis!" ); responseFuture.thenAccept(result -> { log.info("【前端】最终收到响应: {},数据: {}" , result.getStatus(), result.getBody()); }).join(); } public CompletableFuture<ResponseEntity> refresh (String oldRefreshToken) { if (oldRefreshToken == null ) { return CompletableFuture.completedFuture(new ResponseEntity (400 , "Missing refresh token" )); } return CompletableFuture.supplyAsync(() -> { log.info("【Step 1】开始解析 JWT 字符串..." ); String userId = "1024" ; String role = "ADMIN" ; return new UserClaims (userId, role); }, nettyEventLoop) .thenCompose(claims -> { log.info("【Step 2】发起 Redis 异步黑名单检查..." ); String blacklistKey = "blacklist:user:" + claims.getUserId(); return MockRedisClient.hasKeyAsync(blacklistKey) .thenCompose(isBlacklisted -> { if (isBlacklisted) { return CompletableFuture.completedFuture(new ResponseEntity (401 , "Session terminated" )); } log.info("【Step 3】黑名单通过,继续发起 Redis 异步防重放检查..." ); String tokenReuseKey = "used_token:" + Math.abs(oldRefreshToken.hashCode()); return MockRedisClient.hasKeyAsync(tokenReuseKey) .thenCompose(isReused -> { if (isReused) { return CompletableFuture.completedFuture(new ResponseEntity (403 , "Alert: Token reuse!" )); } log.info("【Step 4】防重放检查通过,正在生成全新的双 Token..." ); Map<String, String> tokens = Map.of("accessToken" , "new_access_666" , "refreshToken" , "new_refresh_888" ); log.info("【Step 5】发起 Redis 异步写入,将旧 Token 标记为已消费..." ); return MockRedisClient.setAsync(tokenReuseKey, "used" , 5 ) .thenApply(success -> new ResponseEntity (200 , tokens)); }); }); }); } @Data static class UserClaims { private final String userId; private final String role; } @Data static class ResponseEntity { private final int status; private final Object body; } static class MockRedisClient { private static final ScheduledExecutorService osSelectorExecutor = Executors.newScheduledThreadPool(1 , r -> { Thread t = new Thread (r); t.setName("os-epoll-selector" ); return t; }); public static CompletableFuture<Boolean> hasKeyAsync (String key) { CompletableFuture<Boolean> future = new CompletableFuture <>(); osSelectorExecutor.schedule(() -> { future.complete(false ); }, 100 , TimeUnit.MILLISECONDS); return future; } public static CompletableFuture<Boolean> setAsync (String key, String value, int minutes) { CompletableFuture<Boolean> future = new CompletableFuture <>(); osSelectorExecutor.schedule(() -> { future.complete(true ); }, 100 , TimeUnit.MILLISECONDS); return future; } } }
1
2
3
4
5
6
7
8
22:35:19.830 [main] INFO test01.FutureAuthStateMachine -- 【前端】发起 /auth/refresh 请求... 22:35:19.840 [netty-event-loop-1] INFO test01.FutureAuthStateMachine -- 【Step 1】开始解析 JWT 字符串... 22:35:19.841 [main] INFO test01.FutureAuthStateMachine -- 【Step 2】发起 Redis 异步黑名单检查... 22:35:19.846 [main] INFO test01.FutureAuthStateMachine -- 【网关核心主线程】已经解放!去接待别的前端请求了,不需要卡在这里等 Redis! 22:35:19.947 [os-epoll-selector] INFO test01.FutureAuthStateMachine -- 【Step 3】黑名单通过,继续发起 Redis 异步防重放检查... 22:35:20.051 [os-epoll-selector] INFO test01.FutureAuthStateMachine -- 【Step 4】防重放检查通过,正在生成全新的双 Token... 22:35:20.051 [os-epoll-selector] INFO test01.FutureAuthStateMachine -- 【Step 5】发起 Redis 异步写入,将旧 Token 标记为已消费... 22:35:20.153 [os-epoll-selector] INFO test01.FutureAuthStateMachine -- 【前端】最终收到响应: 200,数据: {refreshToken=new_refresh_888, accessToken=new_access_666}
ThreadPoolExecutor 七大核心参数形象说明
ThreadPoolExecutor 模型:参数作用的形象说明
👨🍳
corePoolSize (核心线程数)
店内正式工 :咖啡馆最基础的员工。即便没有客人(任务),他们也会在店里待着,不会被开除。当新订单进来时,只要正式工还没满载,老板就会优先雇佣正式工。
🛋️
workQueue (任务队列)
排队等候区 :如果正式工都在忙,新来的客人就得去沙发区坐着排队。只有沙发区坐满了,老板才会考虑找临时工帮忙。
🏃
maximumPoolSize (最大线程数)
最大承载量 :正式工忙不过来且沙发区也坐满了,老板紧急招募的“临时工” 。正式工 + 临时工的总数不能超过这个天花板。
⏱️
keepAliveTime & Unit (存活时间)
辞退前的观察期 :当客流量减少,临时工闲着的时间超过这个值,就会被“结账辞退”。但正式工(核心线程)不受这个限制。
🏷️
threadFactory (线程工厂)
人事登记部 :新员工入职时领工牌。你可以给他们起名字、设优先级、标记是否为守护线程等。
🚫
handler (拒绝策略)
拒收方案 :人手全满了,沙发也没座了,新来的客人怎么办?是直接关门拒客(Abort),还是让客人自己回家煮咖啡(CallerRuns)?
这种设计模型实现了 “削峰填谷”。
低负载:只有正式工在,资源消耗小。
突发流量:通过队列缓冲,不至于瞬间压垮系统。
极高负载:通过临时工提升处理速度,如果还是扛不住,通过拒绝策略保护系统不至于 OOM 崩溃。
源码深度拆解 1. 核心控制变量:ctl 的奥秘
在源码的最开头,你会看到这个精妙的设计:
1 2 3 4 5 private final AtomicInteger ctl = new AtomicInteger (ctlOf(RUNNING, 0 ));
2. 核心入口:execute 方法
这是任务进入线程池的第一站。源码逻辑清晰地体现了我们之前提到的上图中的三段式流程:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
public void execute (Runnable command) { if (command == null ) throw new NullPointerException (); int c = ctl.get(); if (workerCountOf(c) < corePoolSize) { if (addWorker(command, true )) return ; c = ctl.get(); } if (isRunning(c) && workQueue.offer(command)) { int recheck = ctl.get(); if (!isRunning(recheck) && remove(command)) reject(command); else if (workerCountOf(recheck) == 0 ) addWorker(null , false ); } else if (!addWorker(command, false )) reject(command); }
3. 工作线程的本质:Worker 内部类
线程池里的线程并不是原生的 Thread,而是被包装成了 Worker。
继承了 AQS:Worker 本身继承了 AbstractQueuedSynchronizer,实现了一个不可重入的锁。这保证了在执行任务时,线程不会被 interruptIdleWorkers(中断空闲线程的操作)所中断。
Runnable 包装:每个 Worker 都是一个任务执行单元,它的 run 方法会调用 runWorker(this)。
4. 线程复用的灵魂:runWorker 与 getTask
为什么线程跑完一个任务不会死掉?答案就在 runWorker 的 while 循环里。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
final void runWorker (Worker w) { Runnable task = w.firstTask; try { while (task != null || (task = getTask()) != null ) { w.lock(); try { beforeExecute(wt, task); task.run(); afterExecute(task, thrown); } finally { task = null ; w.unlock(); } } } finally { processWorkerExit(w); } }
getTask():控制线程生死的闸门,它的内部会根据参数决定如何获取队列任务:
核心线程:通常调用 workQueue.take(),如果队列没任务,它会一直阻塞直到有新包裹进来(对应 keepAliveTime 无效的情况)。
非核心线程:调用 workQueue.poll(keepAliveTime, unit),如果超过存活时间还没拿到任务,就返回 null,导致 runWorker 退出循环,线程销毁。
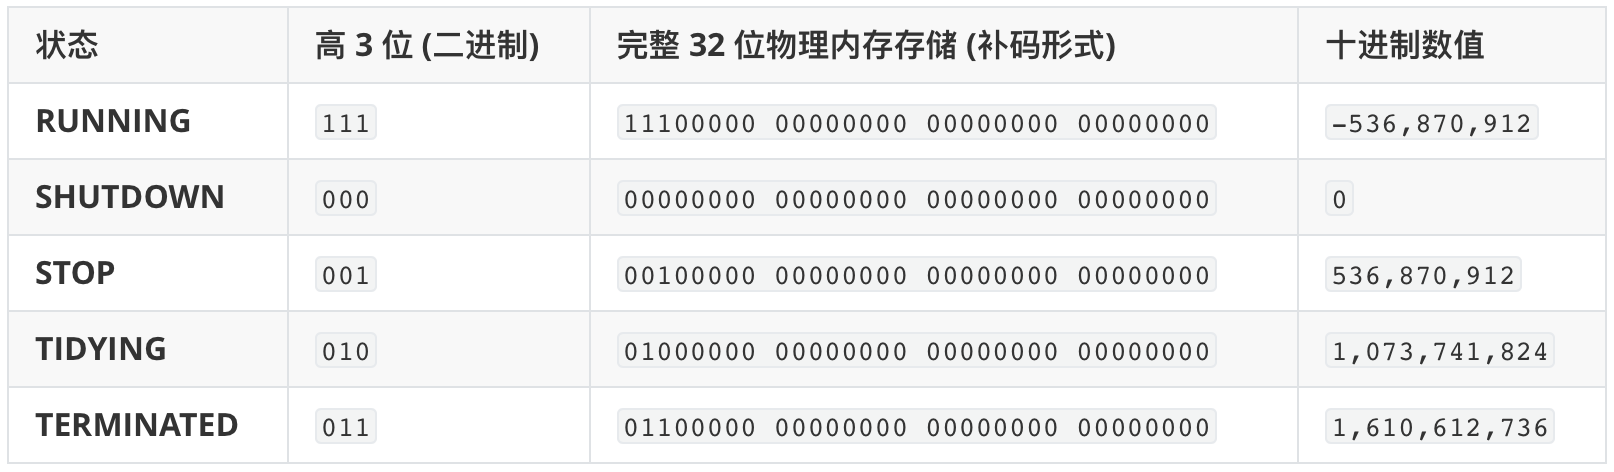
源码中还定义了线程池的 5 种状态,理解它们的流转对故障排查至关重要:
RUNNING:接受新任务,处理队列任务。
SHUTDOW:不接新任务,但处理队列任务。
STOP:不接新任务,不处理队列任务,中断正在跑的任务。
TIDYING:所有任务已终止,线程数为 0,准备执行 terminated()。
TERMINATED:terminated() 执行完毕。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 private final AtomicInteger ctl = new AtomicInteger (ctlOf(RUNNING, 0 ));private static final int COUNT_BITS = Integer.SIZE - 3 ;private static final int COUNT_MASK = (1 << COUNT_BITS) - 1 ;private static final int RUNNING = -1 << COUNT_BITS;private static final int SHUTDOWN = 0 << COUNT_BITS;private static final int STOP = 1 << COUNT_BITS;private static final int TIDYING = 2 << COUNT_BITS;private static final int TERMINATED = 3 << COUNT_BITS;private static int runStateOf (int c) { return c & ~COUNT_MASK; }private static int workerCountOf (int c) { return c & COUNT_MASK; }private static int ctlOf (int rs, int wc) { return rs | wc; }private static boolean runStateLessThan (int c, int s) { return c < s; }private static boolean runStateAtLeast (int c, int s) { return c >= s; }private static boolean isRunning (int c) { return c < SHUTDOWN; }
ThreadPoolExecutor 工作机制模拟
📌 Core: 2
📌 Max: 3
📌 Queue: 3
🚀 Active Threads: 0
📦 Tasks in Queue: 0
执行线程 (Workers)
CORE_1: IDLE
CORE_2: IDLE
MAX_3: CLOSED
等待指令...
⚠️ Rejected!队列已满且达到最大线程数
应用案例 博客内容分发执行器:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
import java.util.concurrent.*;import java.util.concurrent.atomic.AtomicInteger;public class ArticleDistributionManager { private static final int CPU_COUNT = Runtime.getRuntime().availableProcessors(); private static final int CORE_POOL_SIZE = CPU_COUNT * 2 ; private static final int MAX_POOL_SIZE = CPU_COUNT * 4 ; private static final int QUEUE_CAPACITY = 500 ; private static final long KEEP_ALIVE_TIME = 60L ; private final ThreadPoolExecutor executor; public ArticleDistributionManager () { this .executor = new ThreadPoolExecutor ( CORE_POOL_SIZE, MAX_POOL_SIZE, KEEP_ALIVE_TIME, TimeUnit.SECONDS, new LinkedBlockingQueue <>(QUEUE_CAPACITY), new MyThreadFactory ("Content-Distributor" ), new MyRejectHandler () ); this .executor.allowCoreThreadTimeOut(true ); } static class MyThreadFactory implements ThreadFactory { private final String namePrefix; private final AtomicInteger nextId = new AtomicInteger (1 ); MyThreadFactory(String featureName) { this .namePrefix = "OwliasPool-" + featureName + "-Worker-" ; } @Override public Thread newThread (Runnable r) { String name = namePrefix + nextId.getAndIncrement(); Thread t = new Thread (null , r, name, 0 ); t.setDaemon(false ); return t; } } static class MyRejectHandler implements RejectedExecutionHandler { @Override public void rejectedExecution (Runnable r, ThreadPoolExecutor executor) { System.err.println("警报!线程池负载已达极限,任务被拒绝执行。当前队列大小: " + executor.getQueue().size()); } } public void distributeArticle (String articleId) { executor.execute(() -> { try { System.out.println(Thread.currentThread().getName() + " 开始处理文章: " + articleId); Thread.sleep(800 ); System.out.println(Thread.currentThread().getName() + " 完成文章分发: " + articleId); } catch (InterruptedException e) { Thread.currentThread().interrupt(); } }); } public void shutdown () { executor.shutdown(); try { if (!executor.awaitTermination(30 , TimeUnit.SECONDS)) { executor.shutdownNow(); } } catch (InterruptedException e) { executor.shutdownNow(); } } public static void main (String[] args) { ArticleDistributionManager manager = new ArticleDistributionManager (); for (int i = 1 ; i <= 20 ; i++) { manager.distributeArticle("ARTICLE_ID_" + i); } } }
演示实时修改正在运行的线程池参数。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
import org.springframework.web.bind.annotation.*;import java.util.HashMap;import java.util.Map;import java.util.concurrent.*;import java.util.concurrent.atomic.AtomicInteger;@RestController @RequestMapping("/pool/config") public class DynamicThreadPoolController { private static final ThreadPoolExecutor EXECUTOR = new ThreadPoolExecutor ( 2 , 4 , 60 , TimeUnit.SECONDS, new LinkedBlockingQueue <>(100 ), new ThreadFactory () { private final AtomicInteger id = new AtomicInteger (1 ); @Override public Thread newThread (Runnable r) { return new Thread (r, "DynamicPool-" + id.getAndIncrement()); } } ); @GetMapping("/status") public Map<String, Object> getStatus () { Map<String, Object> status = new HashMap <>(); status.put("corePoolSize" , EXECUTOR.getCorePoolSize()); status.put("maximumPoolSize" , EXECUTOR.getMaximumPoolSize()); status.put("activeCount" , EXECUTOR.getActiveCount()); status.put("poolSize" , EXECUTOR.getPoolSize()); status.put("queueSize" , EXECUTOR.getQueue().size()); status.put("completedTaskCount" , EXECUTOR.getCompletedTaskCount()); return status; } @PostMapping("/update") public String updateConfig (@RequestParam int coreSize, @RequestParam int maxSize) { if (coreSize > maxSize) { return "Error: Core size must be less than or equal to max size!" ; } int oldCore = EXECUTOR.getCorePoolSize(); int oldMax = EXECUTOR.getMaximumPoolSize(); EXECUTOR.setCorePoolSize(coreSize); EXECUTOR.setMaximumPoolSize(maxSize); return String.format("Success! Core: %d -> %d, Max: %d -> %d" , oldCore, coreSize, oldMax, maxSize); } }
当调用 setCorePoolSize(newSize) 时,线程池内部会发生以下动作:
如果新值小于旧值:线程池不会立刻杀掉多余线程,而是等它们完成当前任务后,在下一次获取任务getTask() 时,因为数量超过了新核心数,它们会被回收。
如果新值大于旧值:线程池会立即计算差值,并根据需要启动新的工作线程 Worker 来处理队列中堆积的任务。
需要注意的是:
线程池的队列容量无法动态修改:因为原生的 LinkedBlockingQueue 的 capacity 字段是 final 的,无法通过 API 直接修改。如果需要动态修改队列大小,可以自定义一个类继承 LinkedBlockingQueue,并去掉 capacity 的 final 修饰符,提供 Setter 方法。
实际项目中,通常不会通过 Controller 手动改,而是接入 Apollo 或 Nacos。监听配置中心的 Key 变化 -> 触发回调函数 -> 执行 EXECUTOR.setCorePoolSize()。
不要盲目调优。可以配合 Prometheus + Grafana,将 getStatus() 中的数据打入时序数据库,观察线程池的利用率曲线。如果 activeCount 长期接近 maximumPoolSize,才是该加人的时候。
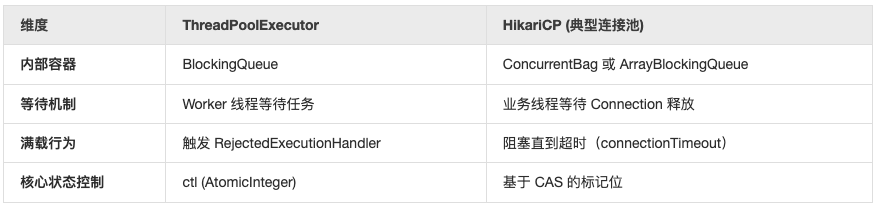
线程池和连接池的对比 线程池和常用的连接池都不约而同地采用了 池化思想,它们的核心在于 “复用那些创建和销毁成本极高的对象”。
线程的创建涉及内核态切换和栈空间分配(约 1MB)。
TCP 连接的创建涉及三次握手、身份验证以及数据库端的进程/线程开销。
它们都是通过 “空间换时间”,在内存中维护一组长寿对象,从而降低系统的响应延迟。它们的不同点在于,虽然都叫 “池”,但管理的资源对象、阻塞机制以及解决的问题有显著区别。
核心差异在于管理工人 vs 管理工具 :线程池(Thread Pool)管理的是执行力(CPU 资源)。线程像是一个 “工人”,它通过主动去拿任务(Runnable)来干活。连接池 (Connection Pool) 管理的是通道(I/O 资源),它本身并不具备执行任务的能力,它只是一个存放昂贵资源的容器。连接(如 JDBC、Redis 连接)更像是一个 “扳手”。工人(线程)需要拧螺丝时,去池里借一把扳手,用完后再还回去。交互逻辑的倒置 :在 Java 源码层面,两者的交互逻辑是相反的:线程池是把任务 execute(task) 丢进去,线程池内部的 Worker 线程通过 workQueue.take() 阻塞式地抢任务。连接池是你的业务线程主动调用 dataSource.getConnection()。如果池子里没连接了,业务线程会调用 condition.await() 挂起,直到有其他线程还回连接。
手撕一个线程池 Step 1:最简版线程池
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
import java.util.ArrayList;import java.util.List;import java.util.concurrent.BlockingQueue;import java.util.concurrent.LinkedBlockingQueue;public class MyThreadPool { private final BlockingQueue<Runnable> workQueue; private final List<Worker> workers = new ArrayList <>(); private final int corePoolSize; public MyThreadPool (int corePoolSize, int queueCapacity) { this .corePoolSize = corePoolSize; this .workQueue = new LinkedBlockingQueue <>(queueCapacity); for (int i = 0 ; i < corePoolSize; i++) { Worker w = new Worker (); workers.add(w); new Thread (w, "worker-" + i).start(); } } public void execute (Runnable task) { try { workQueue.put(task); } catch (InterruptedException e) { Thread.currentThread().interrupt(); } } private class Worker implements Runnable { @Override public void run () { while (true ) { try { Runnable task = workQueue.take(); task.run(); } catch (InterruptedException e) { Thread.currentThread().interrupt(); break ; } } } } public static void main (String[] args) { MyThreadPool pool = new MyThreadPool (2 , 10 ); for (int i = 1 ; i <= 5 ; i++) { int taskId = i; pool.execute(() -> { System.out.println(Thread.currentThread().getName() + " 执行任务 " + taskId); try { Thread.sleep(1000 ); } catch (InterruptedException e) {} }); } } }
输出(这就是线程池的本质:N 个线程 + 1 个阻塞队列 + 死循环取任务。 )
1
2
3
4
5
6
7
worker-0 执行任务 1 worker-1 执行任务 2 (1 秒后) worker-0 执行任务 3 worker-1 执行任务 4 (1 秒后) worker-0 执行任务 5
Step 2:加 core / max + 动态扩容
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
import java.util.concurrent.*;import java.util.concurrent.atomic.AtomicInteger;import java.util.concurrent.locks.LockSupport;public class MyThreadPool2 { private final int corePoolSize; private final int maximumPoolSize; private final long keepAliveTime; private final TimeUnit keepAliveUnit; private final BlockingQueue<Runnable> workQueue; private final RejectedExecutionHandler rejectHandler; private final AtomicInteger ctl = new AtomicInteger (0 ); private volatile boolean shutdown = false ; public interface RejectedExecutionHandler { void rejected (Runnable r, MyThreadPool2 executor) ; } public MyThreadPool2 (int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, RejectedExecutionHandler rejectHandler) { this .corePoolSize = corePoolSize; this .maximumPoolSize = maximumPoolSize; this .keepAliveTime = keepAliveTime; this .keepAliveUnit = unit; this .workQueue = workQueue; this .rejectHandler = rejectHandler; } public void execute (Runnable task) { if (shutdown) { rejectHandler.rejected(task, this ); return ; } while (true ) { int c = ctl.get(); if (c < corePoolSize) { if (addWorker(task, true )) return ; continue ; } if (workQueue.offer(task)) { return ; } if (c < maximumPoolSize) { if (addWorker(task, false )) return ; continue ; } rejectHandler.rejected(task, this ); return ; } } private boolean addWorker (Runnable firstTask, boolean core) { int c = ctl.get(); int max = core ? corePoolSize : maximumPoolSize; if (c >= max) return false ; if (!ctl.compareAndSet(c, c + 1 )) { return false ; } Worker worker = new Worker (firstTask); Thread t = new Thread (worker, "pool-thread-" + c); worker.thread = t; t.start(); return true ; } private class Worker implements Runnable { Runnable firstTask; Thread thread; volatile boolean running = true ; Worker(Runnable firstTask) { this .firstTask = firstTask; } @Override public void run () { Runnable task = firstTask; if (task != null ) { firstTask = null ; task.run(); } while (running && !shutdown) { try { task = workQueue.poll(keepAliveTime, keepAliveUnit); if (task != null ) { task.run(); } else { if (ctl.get() > corePoolSize) { running = false ; ctl.decrementAndGet(); break ; } } } catch (InterruptedException e) { } } } void interrupt () { if (thread != null ) thread.interrupt(); } } public static class AbortPolicy implements RejectedExecutionHandler { public void rejected (Runnable r, MyThreadPool2 e) { throw new RejectedExecutionException ("Task rejected" ); } } public static class CallerRunsPolicy implements RejectedExecutionHandler { public void rejected (Runnable r, MyThreadPool2 e) { r.run(); } } public static class DiscardPolicy implements RejectedExecutionHandler { public void rejected (Runnable r, MyThreadPool2 e) { } } public static void main (String[] args) { MyThreadPool2 pool = new MyThreadPool2 ( 2 , 4 , 3 , TimeUnit.SECONDS, new LinkedBlockingQueue <>(2 ), new CallerRunsPolicy () ); for (int i = 1 ; i <= 8 ; i++) { int id = i; pool.execute(() -> { System.out.println(Thread.currentThread().getName() + " 执行任务 " + id); try { Thread.sleep(2000 ); } catch (InterruptedException e) {} }); System.out.println("提交任务 " + id); } } }
执行流程推演(队列容量=2,core=2,max=4)
1
2
3
4
5
6
7
8
提交任务 1 → 线程数 0 < core(2) → 创建 worker-0,直接执行任务 1 提交任务 2 → 线程数 1 < core(2) → 创建 worker-1,直接执行任务 2 提交任务 3 → 线程数 2 >= core → 队列.offer → 进队列(队列: [3]) 提交任务 4 → 队列.offer → 进队列(队列: [3, 4]) 提交任务 5 → 队列满 → 线程数 2 < max(4) → 创建 worker-2,直接执行任务 5 提交任务 6 → 队列满 → 线程数 3 < max(4) → 创建 worker-3,直接执行任务 6 提交任务 7 → 队列满 → 线程数 4 == max → CallerRunsPolicy → main 线程自己跑任务 7 提交任务 8 → 队列满 → 线程数 4 == max → CallerRunsPolicy → main 线程自己跑任务 8
完全符合流程:core → queue → max → reject。
ScheduledThreadPoolExecutor 在 JUC 体系中,ScheduledThreadPoolExecutor 是专门用来处理延时任务和周期性任务的 “定时炸弹”。相比于传统的 Timer,它解决了单线程阻塞和异常崩溃导致后续任务失效的问题,是 “系统自动化运维” 的核心组件。
工作原理 ScheduledThreadPoolExecutor 核心依靠的是 DelayedWorkQueue(延迟阻塞队列) 和 LockSupport(线程挂起/唤醒)机制,其工作依靠三个核心组件:
A. 任务的封装:ScheduledFutureTask
当你提交一个定时任务时,它会被包装成一个 ScheduledFutureTask。这个对象除了包含你的 Runnable 任务外,还多了两个关键属性:
time:任务下一次应该执行的纳秒级绝对时间。
period:重复执行的间隔时间。
B. 核心容器:DelayedWorkQueue
这是它的 “秘密武器”。这是一个基于小顶堆(Min-Heap)实现的优先级队列。小顶堆的插入和删除复杂度仅为 O(log n),处理成千上万个定时任务也非常高效。
堆顶永远是执行时间最靠前的任务(即最快要到期的任务)。
这种结构使得线程只需要关注“最近的一个任务”,而不需要扫描整个任务列表。
C. 线程的获取逻辑
工作线程(Worker)确实在一个循环中运行,但它在等待任务时是被挂起(Park)的,并不消耗 CPU。
具体的“定时”逻辑如下:
线程从 DelayedWorkQueue 中取出堆顶任务。
计算:delay = 任务执行时间 - 当前时间。
如果 delay <= 0:说明任务到期,立刻执行。
如果 delay > 0:说明还没到点,线程调用 Condition.awaitNanos(delay)。此时,底层调用的是 LockSupport.parkNanos(),结果线程进入等待状态,释放 CPU 资源,由操作系统内核负责在 delay 时间后唤醒该线程。
D. DelayedWorkQueue 的 Leader-Follower 模式
为了防止大量线程在同一时间被唤醒去争抢同一个堆顶任务(惊群效应),DelayedWorkQueue 使用了 Leader-Follower 模式,这极大地减少了不必要的定时器唤醒和线程上下文切换开销:
Leader 线程:第一个到达队列的线程成为 Leader,它被允许进行限时等待(awaitNanos)。它就像是 “守夜人”,到点之后执行自己的任务,并唤醒堆顶的 Follower 让其成为下一个 Leader。
Follower 线程:其他后来的线程发现已经有 Leader 了,它们就不再关注具体时间,而是进入无限期等待(await),它们不需要定闹钟,只需要等 Leader 的信号。
在没有 Leader 模式时,10 个线程会被同时唤醒。而在 Leader 模式下,同一时刻只有一个线程在进行 “定时唤醒”。这避免了大量线程瞬间状态切换带来的 CPU 负荷。每个线程如果调用 awaitNanos(delay) 实际上都会在操作系统底层注册一个定时器。如果线程池很大,成百上千个线程同时注册 10 秒后的定时器,对内核来说是一种压力。而在 Leader 模式下,只有一个线程在维护那个延迟闹钟。由于只有一个 Leader 会在任务到期时醒来,因为其他线程还没被唤醒,它取走堆顶任务时几乎没有竞争。当它取完任务发出信号后,下一个 Leader 才产生。这把原本“并行的哄抢”变成了“有节奏的交接”。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
public E take () throws InterruptedException { final ReentrantLock lock = this .lock; lock.lockInterruptibly(); try { for (;;) { E first = q[0 ]; if (first == null ) available.await(); else { long delay = first.getDelay(NANOSECONDS); if (delay <= 0 ) return finishPoll(first); first = null ; if (leader != null ) available.await(); else { Thread thisThread = Thread.currentThread(); leader = thisThread; try { available.awaitNanos(delay); } finally { if (leader == thisThread) leader = null ; } } } } } finally { if (leader == null && q[0 ] != null ) available.signal(); lock.unlock(); } }
Leader-Follower 模式本质上是一种 “局部负载均衡”。它通过极小的内存开销(一个 Thread 引用),换取了在高并发下极其稳定的 CPU 表现。
常见用法 1. 资源清理与心跳检测 (Heartbeat)
这是最常见的用法。模拟分布式系统中,每隔固定时间向注册中心发送一次心跳,或者定期清理本地缓存。
关键方法:scheduleAtFixedRate(固定速率),适用于资源竞争型任务(如防止多个备份任务重叠执行)。
1
2
3
4
5
6
7
8
ScheduledExecutorService scheduler = Executors.newScheduledThreadPool(1 );scheduler.scheduleAtFixedRate(() -> { System.out.println(Thread.currentThread().getName() + " | 执行心跳检查: " + System.currentTimeMillis()); }, 0 , 5 , TimeUnit.SECONDS);
[注1] scheduleAtFixedRate 的设计初衷是维持总体的执行频率。如果任务超时,它会遵循以下三个原则:绝不并发 :同一个 ScheduledThreadPoolExecutor 中的同一个任务,不会在多个线程中同时跑。即使上一个没完,下一个也不会开始。立即触发 :一旦上一个任务完成,如果此时已经超过了预定的下一个触发点,下一个任务会立刻开始执行。不丢失任务 :它不会因为超时就跳过某个批次,而是会尝试把欠下的次数“补”回来,直到追上预定的时间轴。
[注2] 如果你的任务执行时间长期大于频率时间,会产生以下后果:任务堆积 :虽然不会并发执行,但 DelayedWorkQueue 里的任务会一直处于 “待执行” 状态。线程被占死 :该线程池中的某个线程会被这个任务永久占用,不停地在“干活-结束-立刻干活”之间循环。失去定时意义 :原本的“定时”变成了“连续执行”,失去了波峰波谷的缓冲。
2. 具有“间歇期”的循环任务 (Fixed Delay)
如果任务执行本身很耗时,且你希望前一个任务结束后,再等待固定的时间才开始下一个,则必须使用 scheduleWithFixedDelay。
关键方法:scheduleWithFixedDelay(固定延迟),适用于资源竞争型任务(如防止多个备份任务重叠执行)。
1 2 3 4 5 6 7 scheduler.scheduleWithFixedDelay(() -> { System.out.println("开始执行大文件备份..." ); try { Thread.sleep(10000 ); } catch (InterruptedException e) {} System.out.println("备份完成。" ); }, 1 , 30 , TimeUnit.SECONDS);
3. 超时自动取消 (Self-Cancellation)
结合 ScheduledThreadPool,你可以实现一个简单的 “订单超时未支付自动关闭” 逻辑。
关键方法:schedule(仅执行一次)
1
2
3
4
5
6
7
8
9
10
11
public void createOrder (String orderId) { System.out.println("订单 " + orderId + " 已创建。" ); scheduler.schedule(() -> { if (!isPaid(orderId)) { System.out.println("订单 " + orderId + " 超时未支付,系统自动取消。" ); cancelOrder(orderId); } }, 30 , TimeUnit.MINUTES); }
4. 配合 CompletableFuture 实现超时控制
虽然 Java 9+ 的 CompletableFuture 自带了 orTimeout,但在 Java 8 中,我们通常配合 ScheduledThreadPool 来手动触发异步任务的超时。
1
2
3
4
5
6
7
8
9
10
11
12
CompletableFuture<String> task = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(5000 ); } catch (InterruptedException e) {} return "SUCCESS" ; }); scheduler.schedule(() -> { if (!task.isDone()) { task.completeExceptionally(new TimeoutException ("接口调用超时!" )); } }, 2 , TimeUnit.SECONDS);
避坑指南 异常捕获 :ScheduledThreadPool 有个极大的坑 ——如果任务执行中抛出异常且没有被 try-catch 捕获,该任务将停止后续所有的循环执行,且不会有任何错误日志。所以任务内部必须包一层 try-catch。线程数设置 :如果所有任务都非常准时,核心线程数设为 1 即可;但如果有多个任务并行且有阻塞,建议根据任务量增加核心线程。优雅关闭 :程序停止时记得调用 shutdown(),否则后台线程可能阻止 JVM 退出。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 scheduler.scheduleAtFixedRate(() -> { List<String> records = bankService.fetchRecords(); int count = records.size(); System.out.println("成功对账: " + count + " 条记录" ); }, 0 , 1 , TimeUnit.HOURS); public class ReconcileTaskDemo { private static final Logger log = LoggerFactory.getLogger(ReconcileTaskDemo.class); private final ScheduledExecutorService scheduler = Executors.newScheduledThreadPool(1 ); public void startReconcile () { scheduler.scheduleAtFixedRate(() -> { try { log.info(">>> 开始执行本轮对账..." ); doReconcile(); log.info(">>> 本轮对账执行成功。" ); } catch (Throwable e) { log.error("!!!对账任务发生致命异常,已捕获以防止调度中断" , e); } }, 0 , 1 , TimeUnit.HOURS); } private void doReconcile () { System.out.println("正在处理支付流水..." ); } }
如果项目中有很多定时任务,每个都写 try-catch 太繁琐,可以写一个装饰器(Decorator):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public class SafeRunnable implements Runnable { private final Runnable task; private static final Logger log = LoggerFactory.getLogger(SafeRunnable.class); public SafeRunnable (Runnable task) { this .task = task; } @Override public void run () { try { task.run(); } catch (Throwable t) { log.error("Scheduled task error" , t); } } } scheduler.scheduleAtFixedRate(new SafeRunnable (() -> { }), 0 , 1 , TimeUnit.HOURS);
ForkJoinPool 工作原理 ForkJoinPool 是 JUC 家族中处理 “大任务” 的终极杀手锏。它是 Java 7 引入的,也是 Java 8 Parallel Streams(并行流)底层默认的动力源。它的的逻辑非常直观:
Fork (拆分) :如果任务太大,就递归地拆分成更小的子任务。Join (合并) :等待子任务执行完毕,将结果汇总,逐层向上返回。
核心算法 - 工作窃取算法 (Work-Stealing):
在 ForkJoinPool 中,没有一个 Worker 会袖手旁观。它像是一个极度卷的团队:强者(Worker A)通过 Fork 把任务分细,而‘闲人’(Worker B)会主动去强者队列的最底层搬走最重的那块砖。这种‘双端队列 + 窃取’的机制,让 Java 能够榨干多核 CPU 的最后一丝性能。
普通线程池的弊端 :如果一个线程分配到的任务很重,另一个很轻,轻的干完活后只能闲着(或者去全局队列抢活,产生锁竞争)。ForkJoinPool 的做法 :
每个工作线程(Worker)都有自己的双端队列(Deque)。
线程自己产生的任务(Fork出来的)放在队列头部(LIFO,栈模式,提高缓存命中率)。
窃取行为:当线程 A 忙完了自己队列的所有活,它不会闲着,而是去线程 B 的队列尾部偷一个活来干(FIFO,减少与线程 B 的竞争)。
关键组件:
ForkJoinPool:线程池管理者,负责接收任务并分配给 Worker。
RecursiveTask:有返回值的任务。类似于 Callable。
RecursiveAction:无返回值的任务。类似于 Runnable。
普通的递归是在同一个线程的栈帧中不断压栈,任务多了会 StackOverflow。Fork() 的本质是它是将任务 push 到了当前线程的 WorkQueue 中。如果当前 CPU 还有空闲核心,其他空闲线程会立刻过来 “窃取” 并并行处理,变伪递归为真正的 多核并行。
应用案例 计算一个包含 1000 万个数字的数组之和。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
public class SumTask extends RecursiveTask <Long> { private static final int THRESHOLD = 10 ; private final long [] array; private final int start; private final int end; public SumTask (long [] array, int start, int end) { this .array = array; this .start = start; this .end = end; } @Override protected Long compute () { if (end - start <= THRESHOLD) { long sum = 0 ; for (int i = start; i < end; i++) { sum += array[i]; } return sum; } else { int middle = (start + end) / 2 ; SumTask leftTask = new SumTask (array, start, middle); SumTask rightTask = new SumTask (array, middle, end); leftTask.fork(); rightTask.fork(); return leftTask.join() + rightTask.join(); } } public static void main (String[] args) { ForkJoinPool pool = new ForkJoinPool (); long [] numbers = {1 ,2 ,3 ,4 ,5 ,6 ,7 ,8 ,9 ,10 ,11 ,12 ,13 ,14 ,15 }; long result = pool.invoke(new SumTask (numbers, 0 , numbers.length)); System.out.println("最终结果: " + result); } }
避坑指南 避免在任务中进行 I/O 阻塞 :ForkJoinPool 是为 CPU 密集型任务设计的。如果子任务在等待数据库或网络,会导致工作窃取失效,甚至导致全员阻塞。
合理设置阈值 :如果 THRESHOLD 太小,拆分的开销(创建对象、入队出队)可能超过计算本身的收益;如果太大,则无法发挥并行的优势。
Join 的顺序 :一定要先 fork() 完所有子任务,再统一 join()。如果你 fork() 一个紧接着 join() 一个,它就退化成了串行。